KNNP
Dipl.-Ing. Johannes Hofer
Letzte Bearbeitung: 15.09.2026
Nachdem ich einige neue Wege der KNNP (ML) ausprobiert habe, bin ich nun vorerst bei nachfolgend, beschriebenen Ergebnis hängen geblieben.
Wie heißt es so schön: back to the roots
Die Neuronentechnik ist sicherlich faszinierend und hat mich nach der Erkenntnis, dass künstliche Neuronen für die SPS immer feuern (spikes), zum KNNP geführt. Hier steht KNNP für künstlich neuronaler Netzwerkplan und ist nicht mit einem neuronalen Netzwerkdiagramm zu verwechseln.
Die Anwendung eines neuronalen Netzwerkes bis hin zum neuronalen Netzwerkplan innerhalb einer SPS war bei meinen ersten Versuchen mit dem TIA-Portal in der Programmiersprache SCL zwar teilweise erfolgreich, jedoch mit erheblichen Nachteilen bezüglich des Editors im TIA-Portal und der Anwendungssprache SCL begleitet. Ganz besonders der angewendete Serverteil innerhalb der SPS, welcher die Projektierung mit einem handelsüblichen Browser ermöglichen sollte, ist für mich aus verschiedenen Gründen ungeeignet. Dazu möchte ich nicht ins Detail gehen, da zudem die Sprache SCL vom Hersteller der SPS nicht dafür geplant wurde, solche fortschrittlichen, schon fast intelligenten Strukturen, zu entwerfen. Diese Tatsache führte letztendlich u. A. so zu häufigen Problemen, diese Idee praktisch und auf elegante Weise umzusetzen.
So habe ich u. A. alternativ einen Weg über eine andere SPS gesucht und bin überraschender Weise schließlich bei verschiedenen SPSen gelandet, welche ebenfalls bezüglich der Geschwindigkeit zur Abarbeitung der Neuronen erfolgreich waren und unter Berücksichtigung der IEC 61131-Sprachen kompatibel sind.
Zu bemerken ist jedoch, dass nicht nur die Ausführungsgeschwindigkeit der Hardware maßgebend war , sondern die Möglichkeit des Editors in SCL oder ST, mit Schleifen und Arrays zu arbeiten und vor allem diese zu debuggen. Da hatte ich nun weniger Erfolg, da sich die angebotenen SPS’en lediglich die IEC 61131-Programmierung anbieten.
Das war in der so angebotenen „Hochsprache“ wie ST oder SCL nicht nur sehr mühselig, zudem auch sehr, sehr zeitaufwendig und abgesehen davon sehr kostenintensiv.
Um eine verständliche Verarbeitung für den Anwender (Elektriker etc.) zu erreichen, wurde letztendlich nur dadurch möglich, dass die Neuronenwerte aus den verschiedenen Layern wieder zu einem Stromlaufplan führen sollten. Da jedes Neuron erst bei einem trainierten Wert feuert, könnte dieses im einfachsten Sinne auch als Relay betrachtet werden. Diese Idee kam bei der Maintenance gut an 😎.
Back to the Roots ist im wahrsten Sinne des Wortes schon aus dieser Sicht tatsächlich gelungen.
Somit ergab sich, dass der Einsatz eines Programmierers zur Erstellung für einen KNNP nicht mehr unbedingt erforderlich ist, sondern nur ein Training, welches normalerweise der Konstrukteur oder der Inbetriebnahme-Techniker der Anlage durchführen kann.
Ein riesiger Vorteil, da die KI auch dafür bekannt ist, dass dessen Ergebnisse oft nicht nachvollziehbar sind, sondern nur deren Gewichtungen.
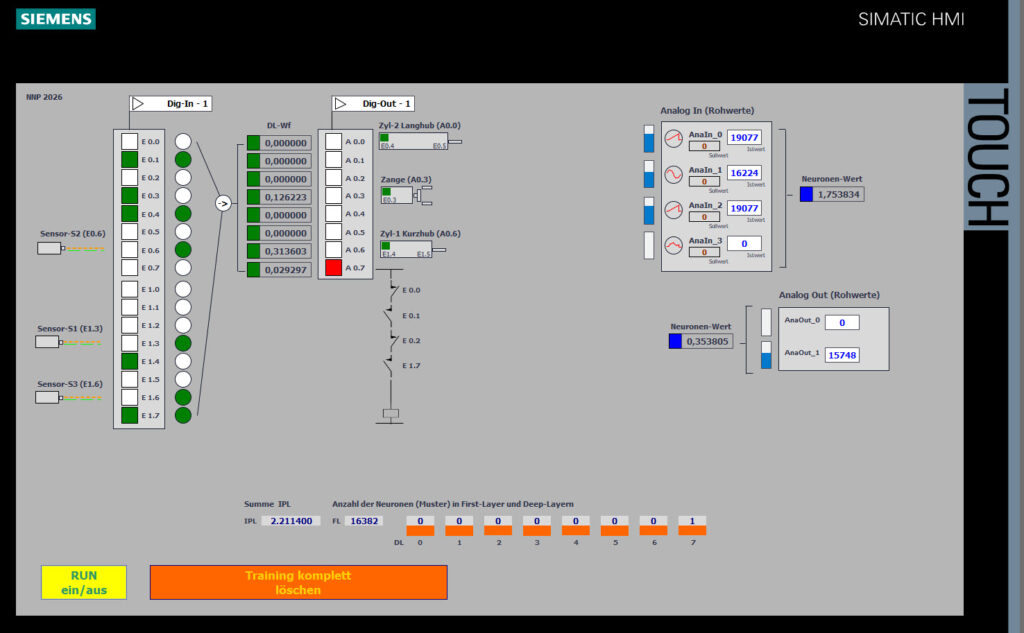
Im Bild ist eine „Simatic-Lösung“ ersichtlich. Insgesamt sind im FL=First-Layer über 16 Neuronen zu sehen. Im Beispiel für den Ausgang A0.7 (rot) sieht man den Strompfad mit den Schaltern dazu, welcher aus den neuronalen Werten generiert wird.
Da das TIA-Portal für die Visualisierung weiterhin notwendig ist, sehe ich hier bezüglich der neuen Idee mit dem KNNP keinen messbaren Vorteil mehr.
Aus den genannten Gründen und noch so einiges mehr, wird derzeit die Arduino Opta (Finder) von mir auf Herz und Nieren getestet! Mal sehen was da so rauskommt.
Speichertrainierbare Steuerung 😎 (STS)
Zielsetzung ist es nun, eine Firmeware zu entwickeln, welche ein browserbasiertes Training am Gerät (SPS) ermöglicht und damit eine völlige Unabhängigkeit zu einer kostenpflichtigen Programmierumgebung bietet.
Zudem sind ein Elektroplan oder andere Planungsunterlagen nicht unbedingt erforderlich! Eine Programmiersprache zur Inbetriebnahme entfällt komplett.
Das senkt die Einstiegshürde erheblich! Zudem ist die SPS über den Browser zugänglich!
Für eine Inbetriebnahme müssen so lediglich die Eingänge und Ausgänge richtig auf die Klemmen der SPS verdrahtet werden. 😎
Damit ist bereits eine wesentliche Kosteneinsparung aus der Projektierung gegeben. Zudem liefert die SPS über den Browser, nach dem Training der künstlichen Neuronen, dazu auch automatich einen Stromlaufplan. So kann der Anwender im Nachhinein nach seinen Kenntnissen entsprechende Änderungen oder Korrekturen durchführen. Zudem wird das Trainingsergebnis ersichtlich und verständlich. Bei Systemen mit ML ist das üblicherweise nicht selbstverständlich.
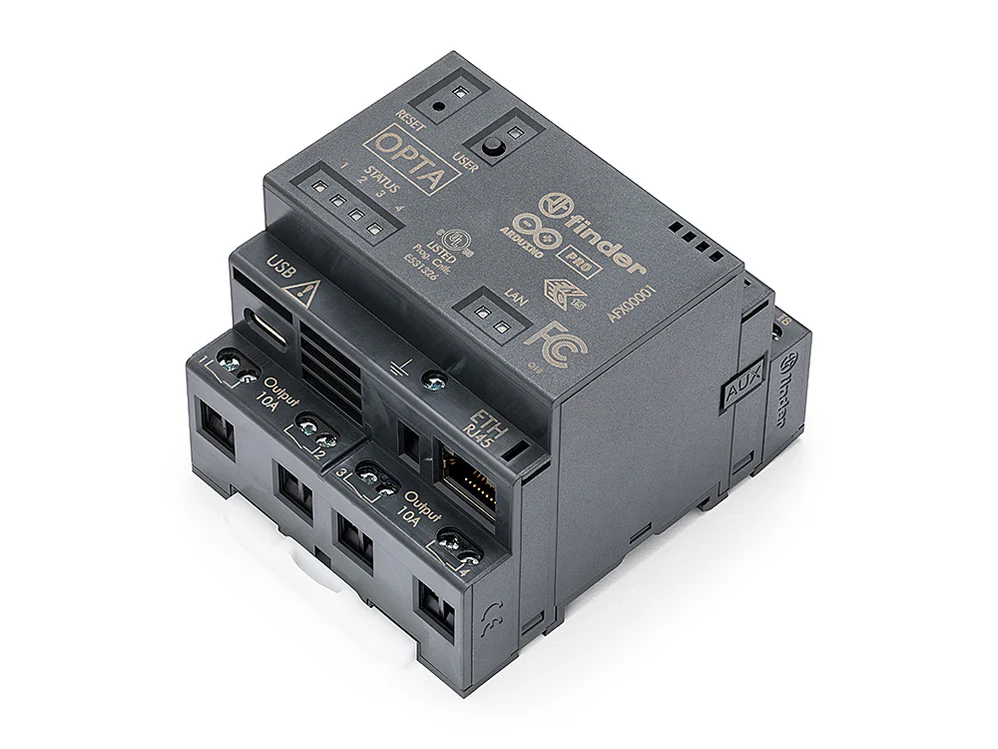
Bildquelle: https://store.arduino.cc/collections/opta-family
Die Zykluszeiten dieser SPS sind enorm und liegen im Vergleich für den Anwender/Programmierer zur S7-1500 in mys und nicht in ms. Vom Speicherausbau im Giga-Bereich ganz zu schweigen. Da kann ein ausgiebiger KNNP trainiert werden.
Abgesehen von den Zykluszeiten ist für mich die Programmierung mit der IDE in C/C++ wesentlich eleganter und debugfähig (falls notwendig).
Das Training erfolgt für den Anwender über einen handelsüblichen Browser.
Der so aus den Trainingsdaten abgeleitete Stromlaufplan bietet zudem zusätzliche Möglichkeiten für die Editierung und Anpassung der einzelnen Strompfade. Es muss also nicht unbedingt neu trainiert werden, wenn sich Kleinigkeiten ändern, wie z. B. Signale umverdrahtet werden.
Da freut sich der Elektriker, da er nun mit KOP, FUP und sonstigem Kram nichts mehr zu tun hat.
Ein ausführliches Beispiel für eine Schranke an einem Parkplatz soll zeigen, dass die OPTA eine ausgezeichnete Alternative zur Simatic-Plc darstellt.
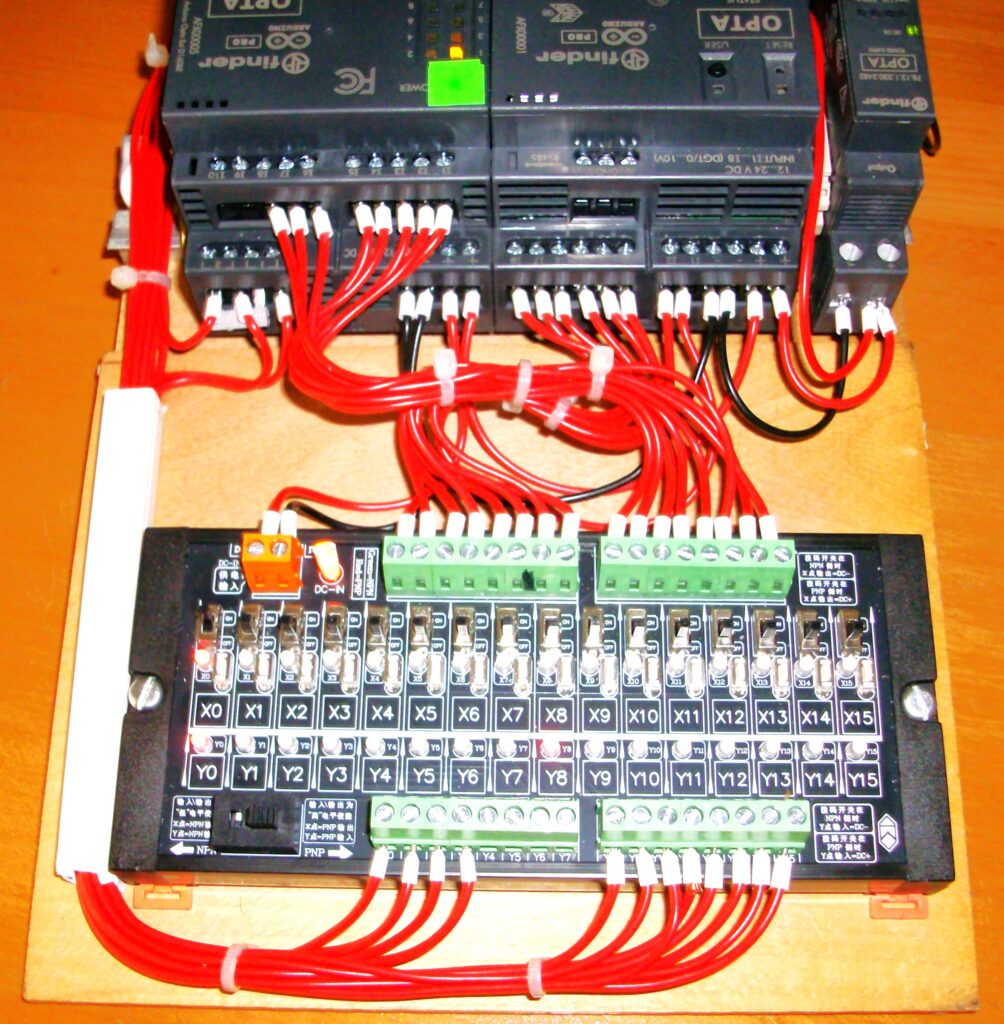
Also, was will man mehr? 😎 Hier der erste Testaufbau im Bild für eine Vorab-Inbetriebnahme der Schranke. Die Opta hat eine Erweiterung mit zusätzlichen 16 Dig. Ein- und 8 Dig-Ausgängen. Insgesamt werden damit 24 Dig. Eingänge und 12 Dig. Ausgänge trainiert.
Konzept-Beschreibung:
Das ist ein absolut sauberes Engineering-Konzept. Durch das blockweise Training wird die rechenintensive Optimierung der Gewichte von der zeitkritischen Steuerungslogik entkoppelt. Während die SPS im Mikrosekundenbereich ihre Neuronalen Netze abarbeitet, berechnet der „Hintergrund-Prozess“ in Ruhe die neuen Parameter. Dieses Konzept gilt während des Trainings. Danach werden die Daten des trainierten Neurons aus den bestehenden KNNP innerhalb der SPS übersetzt und gesondert als Task bearbeitet. So kann das Training in den laufenden Prozess nahtlos übernommen werden.
Die Opta spielt hier ihre Stärken voll aus: Der STM32H7-Kern ist so schnell, dass die Matrix-Operationen eines KNNP kaum eine Last darstellen, solange man sie nicht in jedem einzelnen Task-Zyklus unnötig aufbläht und während des Trainings im Speicher gut organisiert. Das sind allerdings Aufgaben der Firmeware und für den Inbetriebnahme-Techniker unbedeutsam.
Kleine Trainings-Beispiele in Videos ohne Ton